IT之家 11 月 6 日消息,英伟达昨日(11 月 5 日)发布技术解读,指出随着大模型参数规模、上下文长度和智能体应用快速增长,GPU 显存正面临前所未有的压力,HBM 供应趋紧、价格上升,在可以预见的未来仍将持续。
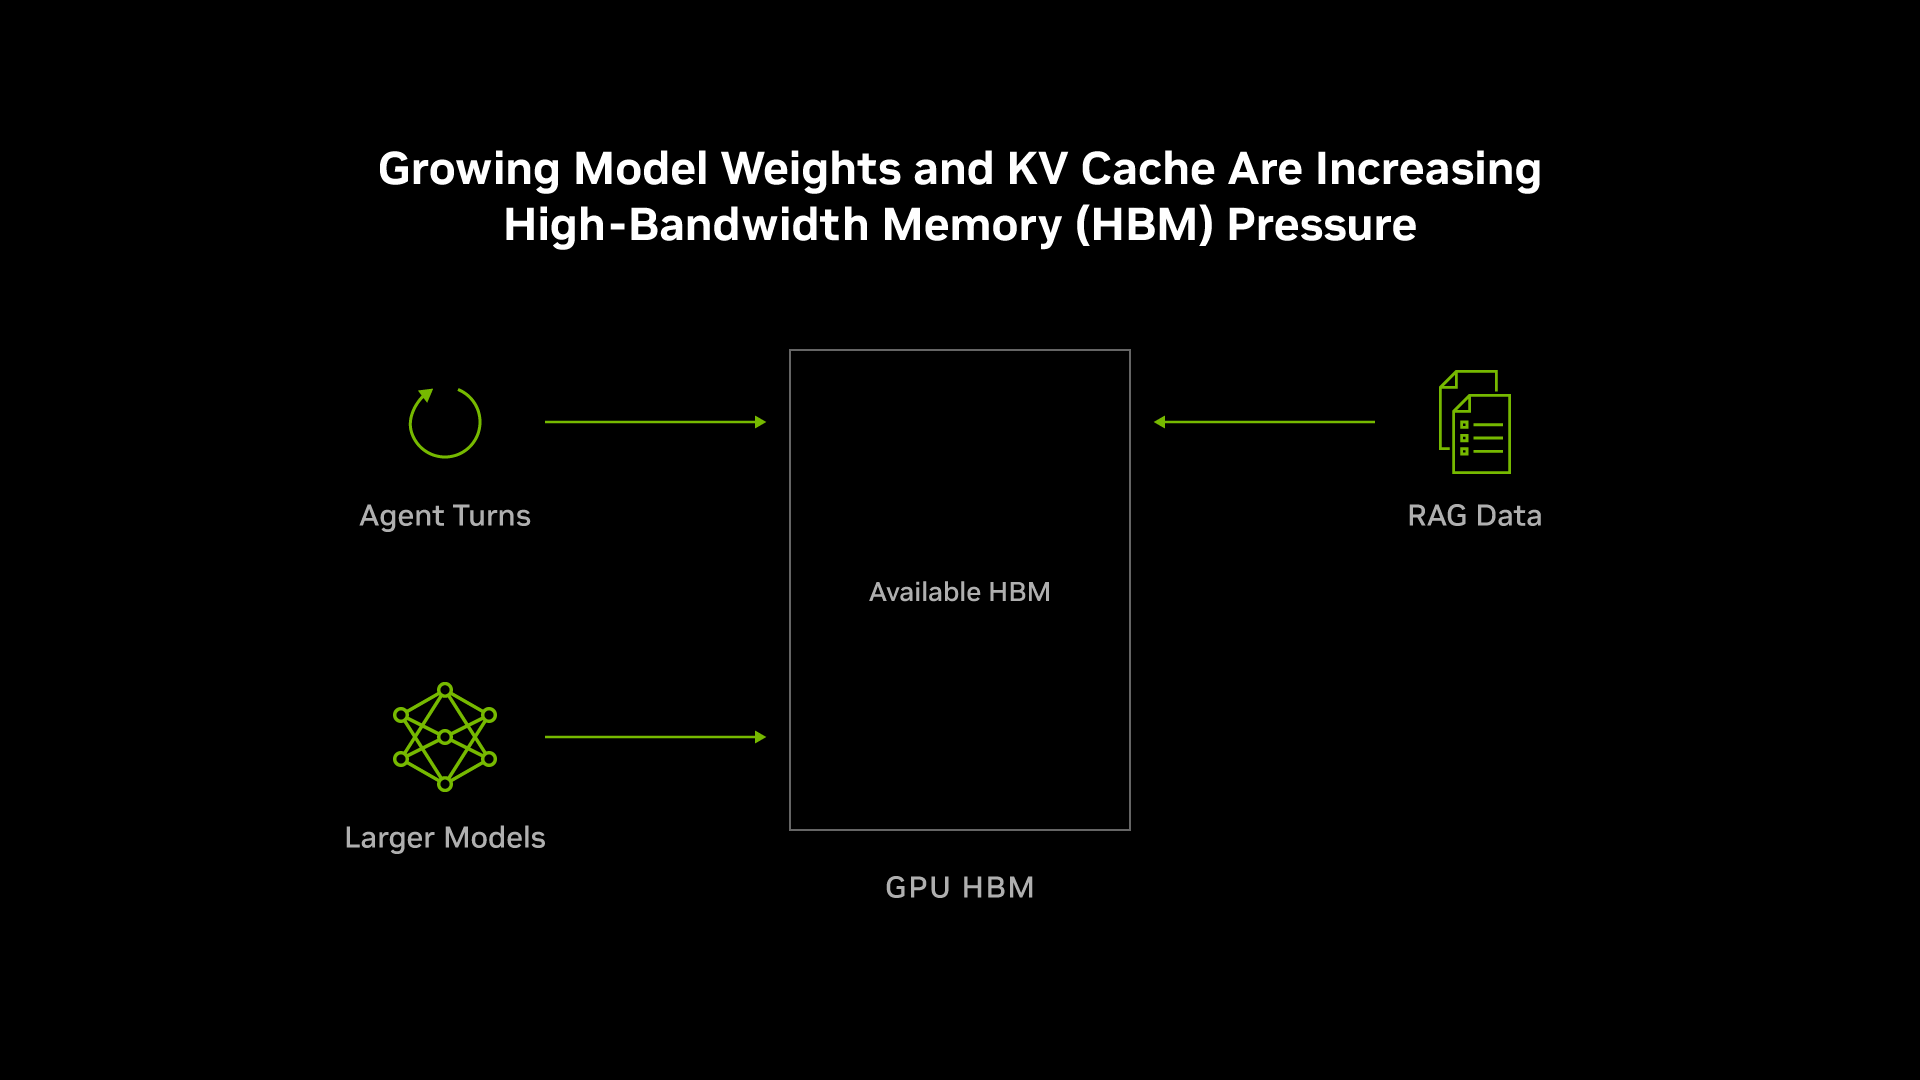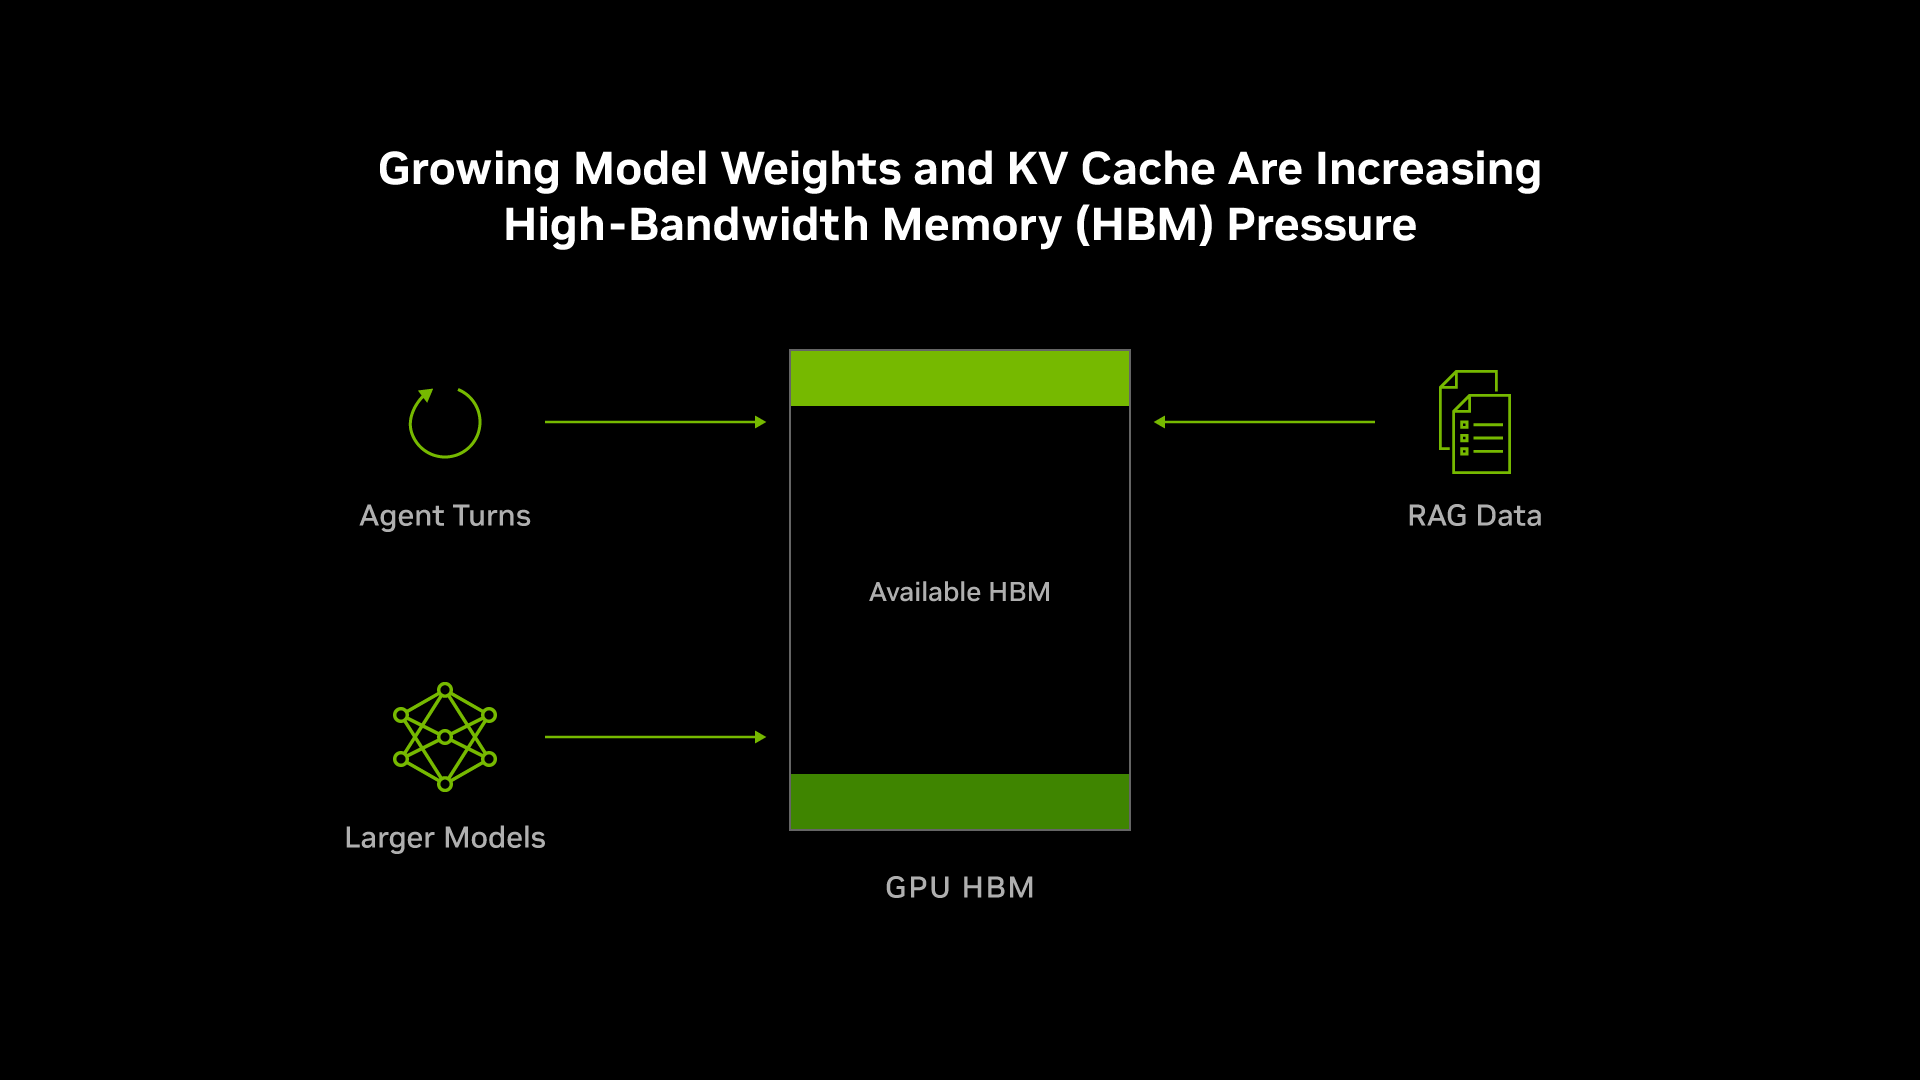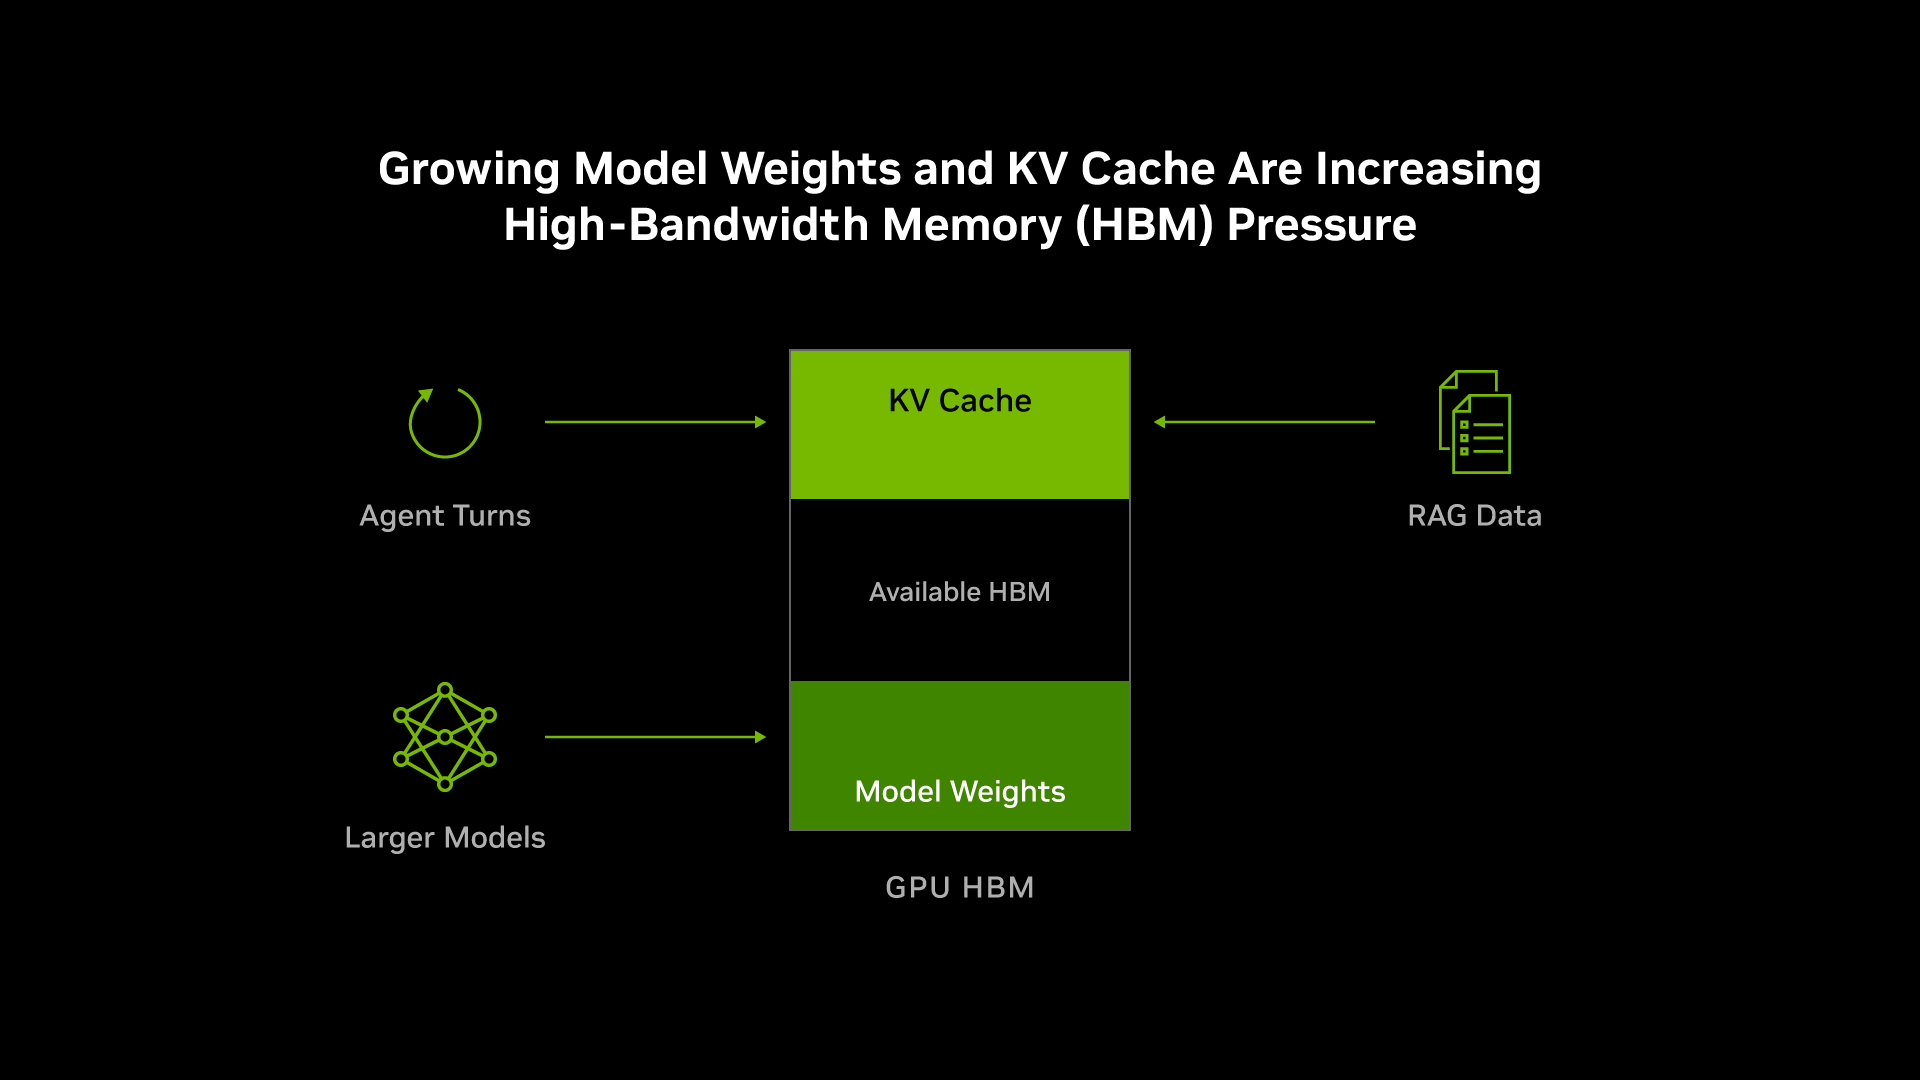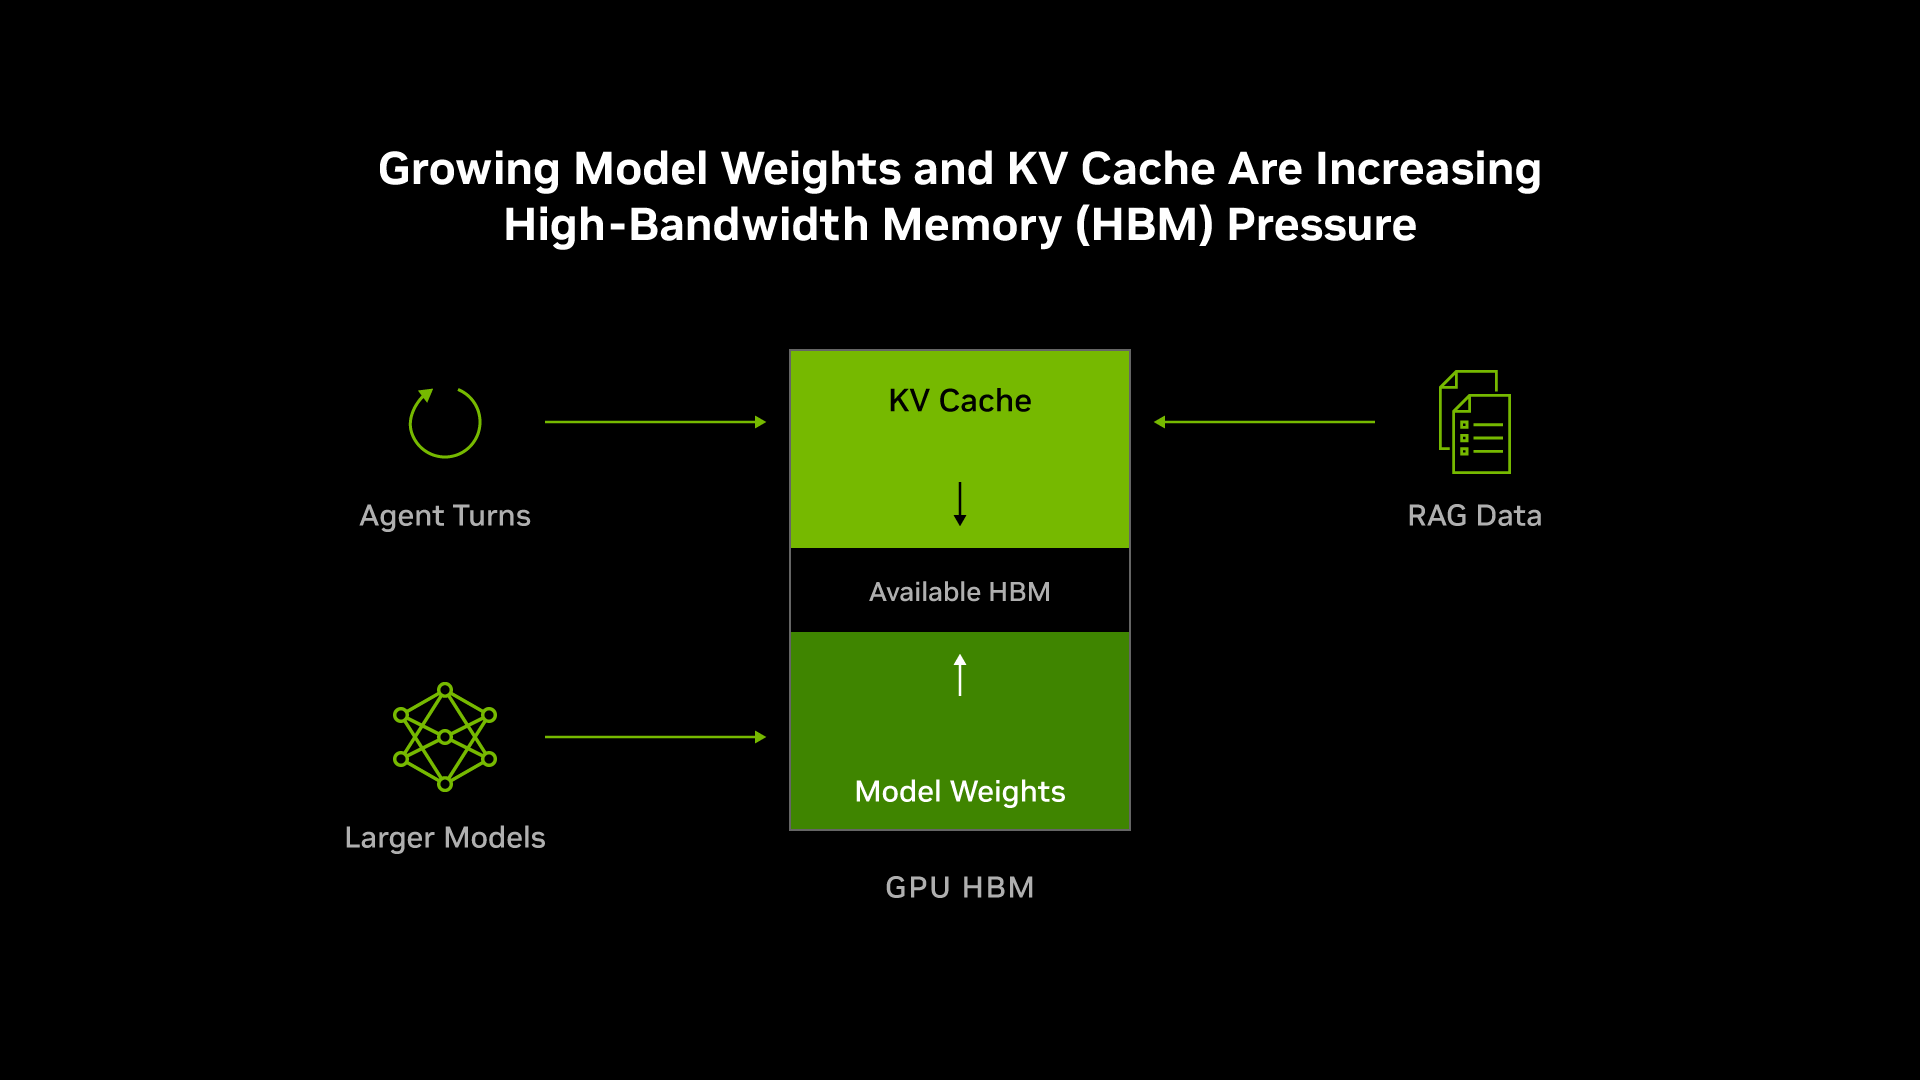
为了破解当前 AI 内存瓶颈,英伟达探索引入了“全栈协同设计”理念,将 GPU、CPU、网络、存储和软件作为一个整体协同设计,让每一字节内存在 AI 工厂的各层级都产生更高价值。IT之家附上相关图片如下:
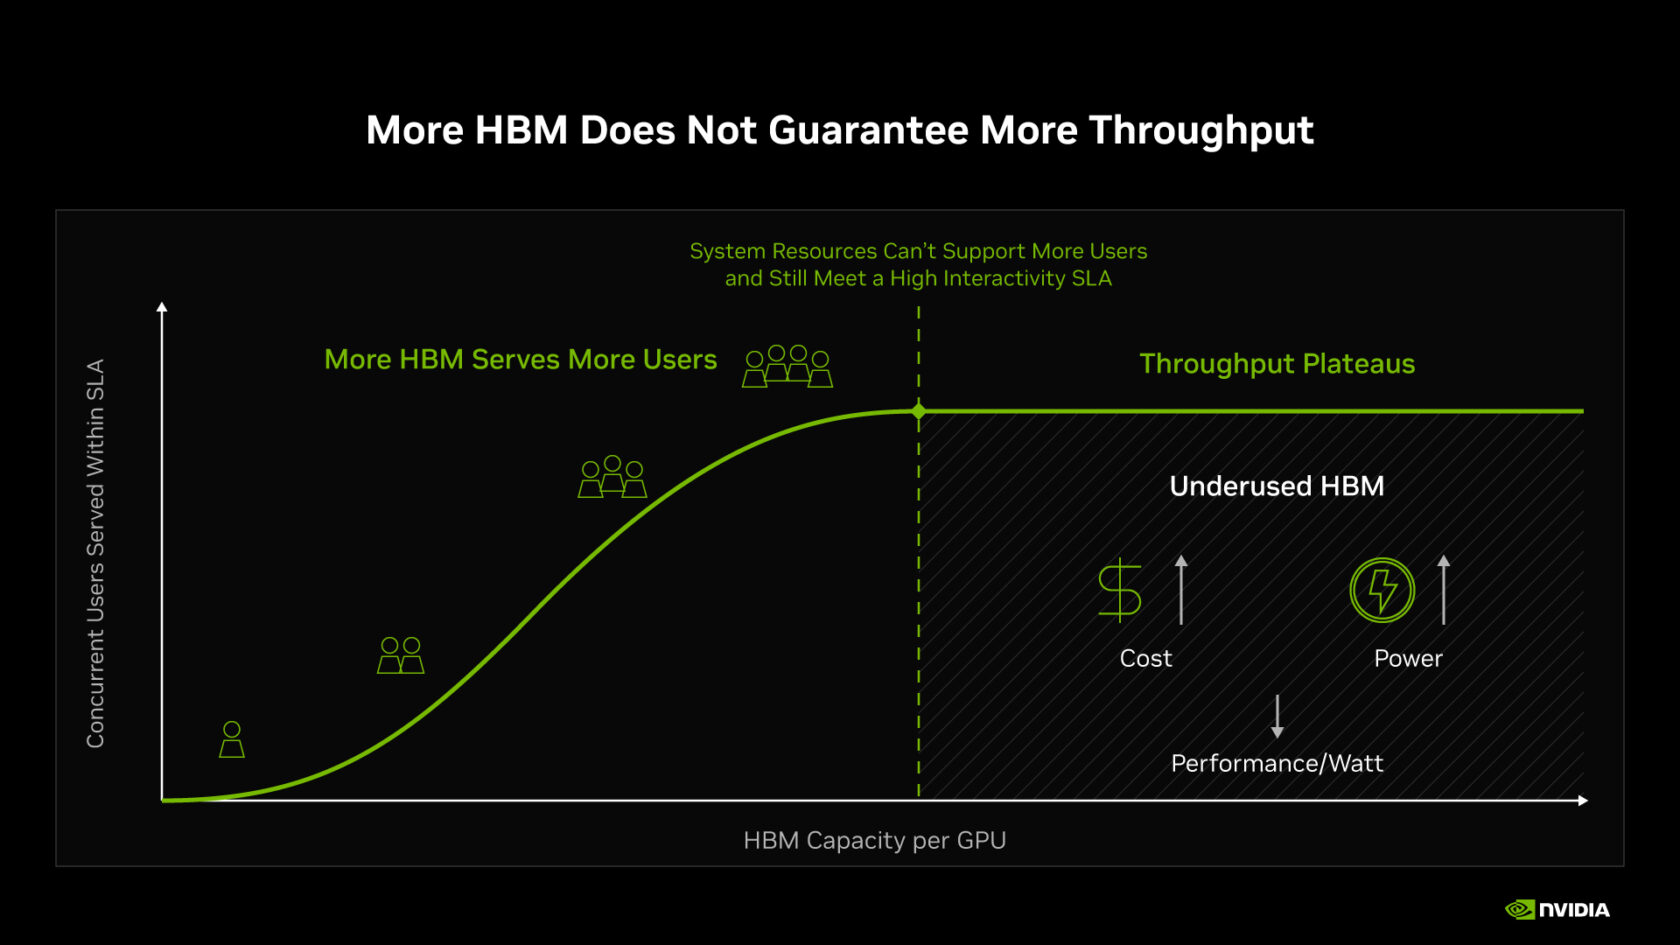
在推理过程中,昂贵的 HBM 既要承载模型权重,也要保存 KV 缓存(用于记录模型理解当前请求所需的上下文)。智能体工作流会在多次模型调用和工具调用间持续携带历史上下文,部分场景需处理多达 300 万个 token;检索增强生成(RAG)还会把企业资料加入提示词,进一步推高内存占用。
英伟达将 HBM 比作仓库、将内存带宽比作装卸口:容量再大,若数据进出速度跟不上,也会形成“内存墙”,导致新增容量无法有效转化为服务能力。因此,其方案强调把数据压缩、放置在合适层级,并在需要前提前送回 GPU。
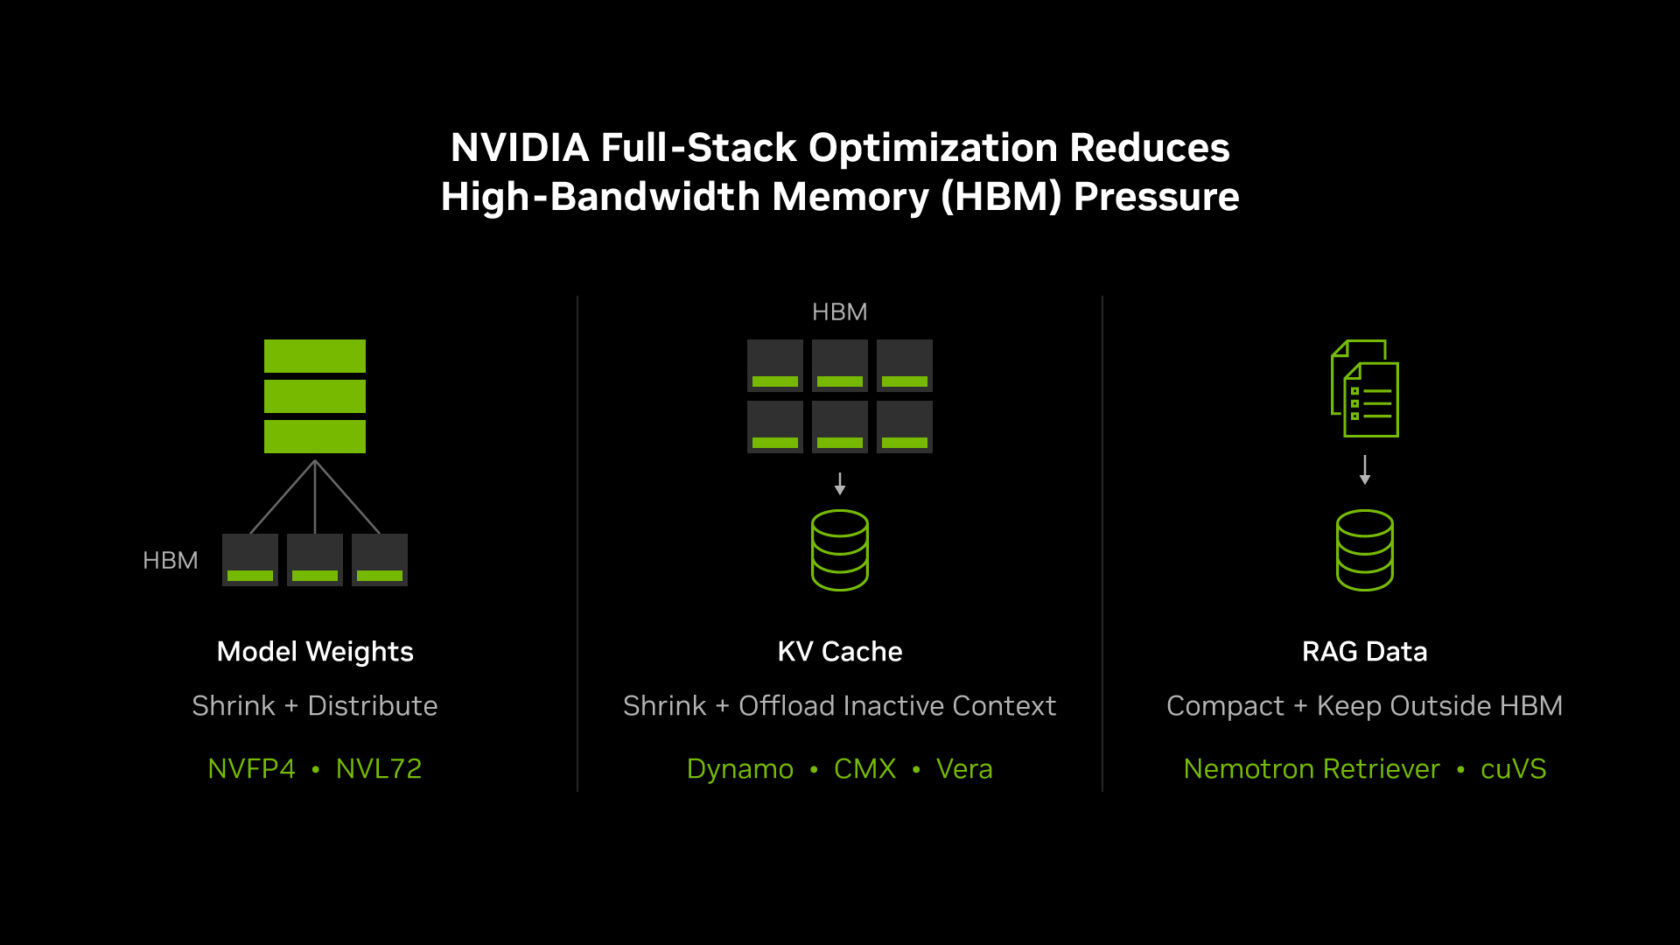
在具体操作中,NVFP4 低精度格式可压缩模型权重和 KV 缓存;在 NVL72 系统中,模型权重可分散至最多 72 颗 GPU;Vera CPU 的大容量 LPDDR 内存可为暂停的上下文提供就近缓冲;Dynamo 推理软件则将不活跃上下文迁移至 CMX 上下文存储,并在复用前取回。RAG 索引也可保留在 CPU 与存储侧,避免长期占用 HBM。
英伟达援引 SemiAnalysis AgentX 基准称,在每用户每秒 125 token 的条件下,Vera Rubin NVL72 相较 GB300 NVL72 的每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量仅增加约 3%。
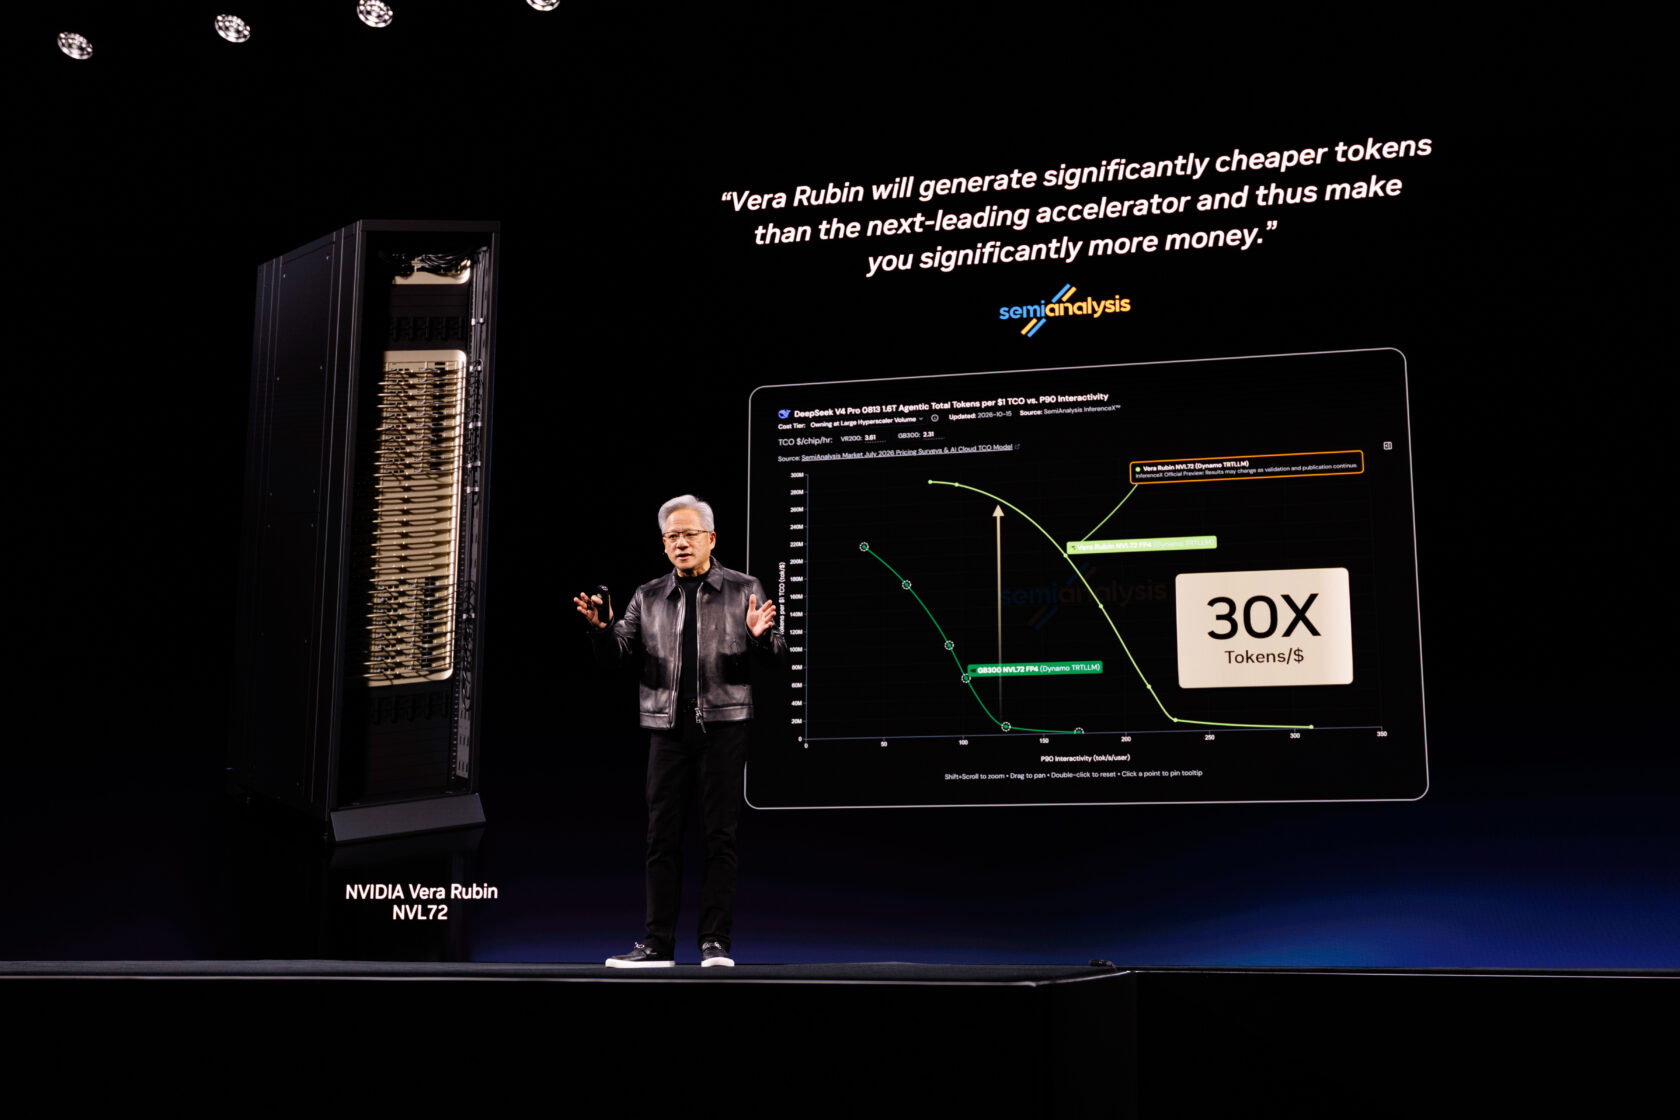
GB300 NVL72 较 H200 平台在每用户每秒 100 token 条件下,每美元吞吐量最高提升 10 倍。这表明,AI 算力竞争的关键正从“显存多少”转向“每字节、每瓦特能产出多少有效 token”。
3条评论
卡隆·巴利纳
2024年5月19日 回复想了解更多专注工业制造本质,以诚信与实力构建长期合作信赖相关内容,尽在&悟空·(中国)体育官方网站-WOKONG SPORTS wukong体育。
朱莉娅·罗伊
2024年5月19日 回复&悟空·(中国)体育官方网站-WOKONG SPORTS wukong体育围绕悟空体育不断创新,回应用户的真实需求。
阿里斯塔·威廉姆森
2024年5月19日 回复精选悟空体育官网内容,&悟空·(中国)体育官方网站-WOKONG SPORTS wukong体育与你一同发现更多精彩。